Un backend antes que una pantalla
Por qué construí toda la API de RedCheck antes que su interfaz, y las decisiones de dentro: autenticación sin sesiones, un único endpoint con filtros y tareas recurrentes que no se acumulan.
With a data model on paper (part 1), the obvious way to start was feature by feature: login, end to end, from the database to the screen; then subjects, end to end; then tasks. Each step would give me something I could click.
I didn’t do that. I built the whole API first, and only then the interface.
Why the backend came first
Working one feature at a time across the whole stack means switching languages and mental models several times a day: Java, Spring and JPA in the morning, React and TypeScript in the afternoon, and back. In a team, different people own different layers. Alone, I was paying the cost of every switch myself.
So I split the work by layer instead: the database, security and business logic first, as a REST API I could test on its own; then the interface on top of a contract that already existed and was documented. The trade-off was clear: for almost three weeks there was nothing to look at, only endpoints. In exchange, when I started on the frontend, every call it needed was already there and already behaved.
The dates in the commit history show what that focus bought. The base, authentication, subjects and tasks went in over three days, 2 to 4 March. Recurring tasks and daily progress, which I’d expected to take a week, went in on a single day, 20 March.
Authentication without sessions
RedCheck uses Spring Security with JSON Web Tokens. Logging in returns a
signed token; the client sends it in the Authorization header with
every request, and a filter validates the signature and expiry before
the request reaches any controller. Passwords are hashed with BCrypt.
The server keeps no sessions at all. That makes every request self-contained and the backend easy to scale or restart, but it has a consequence people tend to discover late: there is nothing on the server to “log out” of. Logging out means the client throws its token away. A stolen token stays valid until it expires, 24 hours later. For a planner, I took that trade-off. For a bank, I wouldn’t.
One of the first commits after setting this up is called fix: forgotten / in requestMatchers. A missing leading slash in the list of public routes had put the Swagger documentation behind authentication. Security configuration fails closed, which is the right default, but it doesn’t tell you why.
Ownership on every request
Every subject, task and recurring task belongs to a user, and every
query is scoped by the authenticated user’s id. Asking for someone
else’s task doesn’t return it, and trying to modify it throws a specific
exception (TaskNotOwnedException, SubjectNotOwnedException) instead
of quietly succeeding.
Controllers also never receive or return entities, only DTOs. If the API accepted entities directly, a client could send fields it should never control, like an id or a creation date, and the framework would happily write them to the database. DTOs make the contract explicit and let the database change without breaking it.
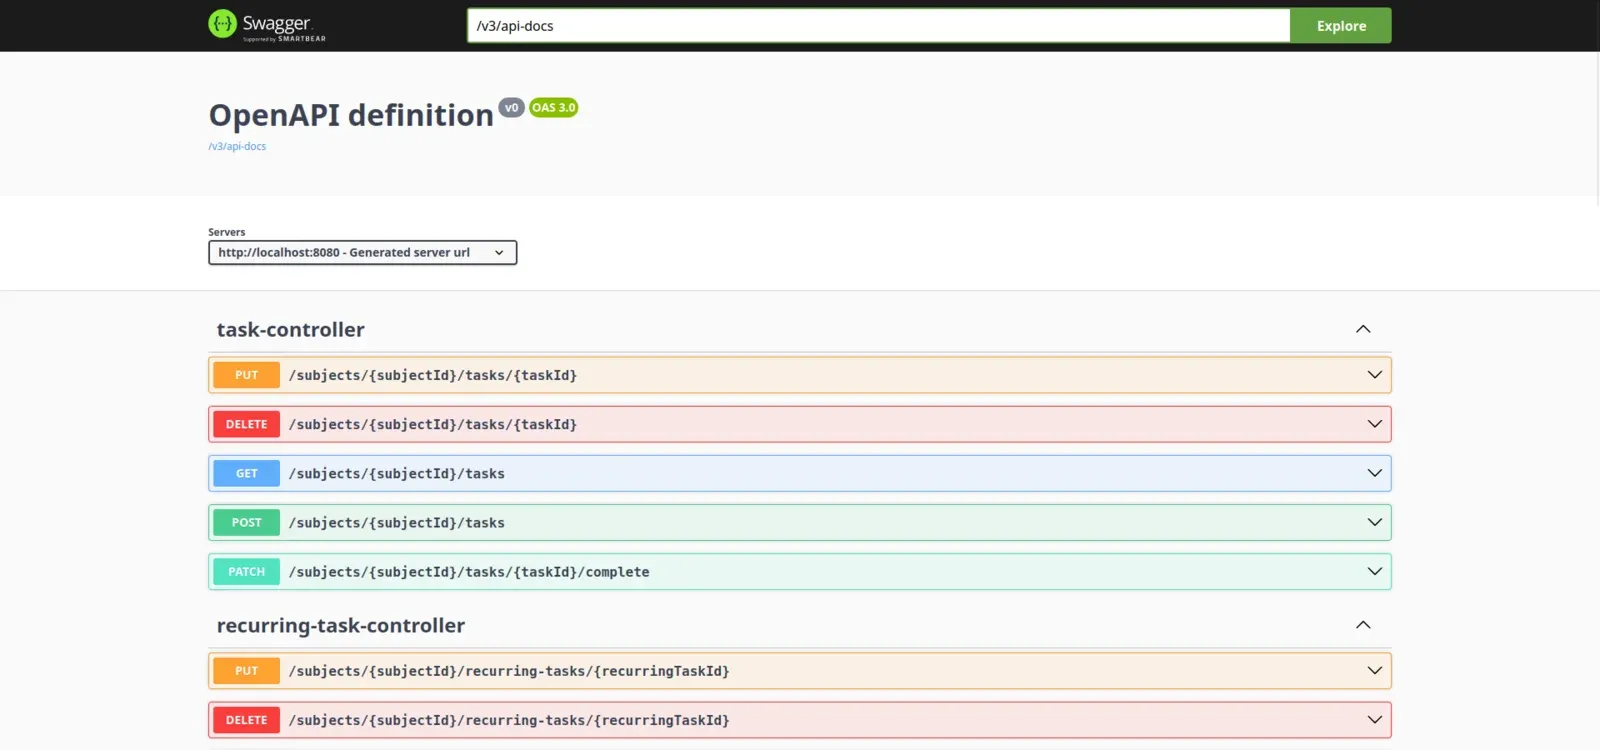
One endpoint, many questions
The interface would need tasks in many combinations: pending tasks of a subject, completed ones, overdue ones. The first approach I considered was a method and a route for each: “pending tasks of a subject”, “overdue tasks”, and so on. It would have worked, and it would have multiplied with every new filter.
Instead, there’s one endpoint, GET /subjects/{id}/tasks, with optional
completed and overdue parameters that the service turns into a single
query. One more decision there: whether a task is overdue is computed on
the server, at the moment of the request, and sent as a field. If every
client worked it out from its own clock and time zone, two devices could
disagree about the same task.
Recurring tasks that don’t pile up
This was the most interesting design problem of the backend.
The classic way to implement a recurring task is to generate all of its future instances when it’s created. A daily task for a year is 365 rows. Stop using the app after a week and 358 of them are dead weight. Worse, if instances keep appearing whether or not you did the last one, a missed week leaves you with seven identical pending tasks: a pile that makes the app feel like a reproach.
RedCheck generates them one at a time. A scheduled job runs every night at midnight and, for each active recurring task, creates the next instance only if two conditions hold: the last instance has been completed, and today is the day the frequency says the next one is due.
The database only holds tasks that are actually relevant, and missing a day never multiplies into a backlog. The trade-off is deliberate: if you don’t complete a recurring task, it doesn’t come back until you do. The first version supported four fixed frequencies: daily, weekly, every two weeks and monthly. Months later, the calendar rework (part 14) replaced that with custom weekdays and streaks.
Progress, stored once a day
The calendar’s colours come from the PROGRESS_RECORD table from part 1.
A second scheduled job runs at 23:59 and takes a snapshot of each user’s
day: the tasks completed that day, against everything that was still
pending. The calendar then reads one row per day instead of counting
tasks.
It’s a classic trade: cheap reads, in exchange for a number that is frozen once written. Complete one of yesterday’s tasks today and yesterday’s colour doesn’t change. For a historical heatmap, where the past rarely changes, that was acceptable. Much later, for streaks, I made the opposite choice and computed them on read, because a stored counter drifts the moment someone un-completes a past task. Same kind of problem, different answer, depending on how often the data changes.
What I took from this stage
- Working alone, splitting by layer beat splitting by feature. The cost was weeks with nothing to show; the payoff was a frontend that never waited on the backend.
- Stateless auth is simple until you need to revoke something. Know that before you pick it.
- The best data is often the data you don’t create. Generating recurring tasks lazily kept both the database and the user’s list clean.
The next part is the other half: turning a sketch into an interface, in ten days.
Con un modelo de datos sobre el papel (parte 1), lo obvio era empezar funcionalidad a funcionalidad: el login, de punta a punta, de la base de datos a la pantalla; luego las asignaturas, de punta a punta; luego las tareas. Cada paso me daría algo que poder pulsar.
No lo hice así. Construí primero toda la API, y solo después la interfaz.
Por qué primero el backend
Trabajar una funcionalidad cada vez a lo largo de todo el stack significa cambiar de lenguaje y de forma de pensar varias veces al día: Java, Spring y JPA por la mañana, React y TypeScript por la tarde, y vuelta a empezar. En un equipo, cada capa tiene su responsable. Yo solo, pagaba el coste de cada cambio.
Así que dividí el trabajo por capas: primero la base de datos, la seguridad y la lógica de negocio, como una API REST que podía probar por sí sola; después la interfaz, encima de un contrato que ya existía y estaba documentado. El compromiso estaba claro: durante casi tres semanas no hubo nada que ver, solo endpoints. A cambio, cuando empecé con el frontend, cada llamada que necesitaba ya estaba ahí y ya funcionaba.
Las fechas del historial de commits muestran lo que compró ese foco. La base, la autenticación, las asignaturas y las tareas entraron en tres días, del 2 al 4 de marzo. Las tareas recurrentes y el progreso diario, que esperaba que me llevaran una semana, entraron en un solo día, el 20 de marzo.
Autenticación sin sesiones
RedCheck usa Spring Security con JSON Web Tokens. Al iniciar sesión se
devuelve un token firmado; el cliente lo envía en la cabecera
Authorization en cada petición, y un filtro comprueba la firma y la
caducidad antes de que la petición llegue a ningún controlador. Las
contraseñas se guardan con BCrypt.
El servidor no guarda ninguna sesión. Eso hace que cada petición sea autosuficiente y que el backend sea fácil de escalar o reiniciar, pero tiene una consecuencia que se suele descubrir tarde: en el servidor no hay nada de lo que “cerrar sesión”. Cerrar sesión significa que el cliente tira su token. Un token robado sigue siendo válido hasta que caduca, 24 horas después. Para un planificador, acepté ese compromiso. Para un banco, no lo haría.
Uno de los primeros commits tras montar esto se llama fix: forgotten / in requestMatchers. Faltaba la barra inicial en la lista de rutas públicas, y eso había dejado la documentación de Swagger detrás de la autenticación. La configuración de seguridad falla cerrando, que es lo correcto por defecto, pero no te dice por qué.
Propiedad en cada petición
Cada asignatura, tarea y tarea recurrente pertenece a un usuario, y cada
consulta se filtra por el id del usuario autenticado. Pedir la tarea de
otra persona no la devuelve, e intentar modificarla lanza una excepción
específica (TaskNotOwnedException, SubjectNotOwnedException) en lugar
de completarse sin más.
Los controladores tampoco reciben ni devuelven nunca entidades, solo DTOs. Si la API aceptara entidades directamente, un cliente podría enviar campos que nunca debería controlar, como un id o una fecha de creación, y el framework los escribiría en la base de datos sin rechistar. Los DTOs hacen explícito el contrato y permiten cambiar la base de datos sin romperlo.
Un endpoint, muchas preguntas
La interfaz iba a necesitar las tareas en muchas combinaciones: las pendientes de una asignatura, las completadas, las atrasadas. El primer enfoque que me planteé fue un método y una ruta para cada caso: “tareas pendientes de una asignatura”, “tareas atrasadas”, etcétera. Habría funcionado, y se habría multiplicado con cada filtro nuevo.
En su lugar hay un único endpoint, GET /subjects/{id}/tasks, con los
parámetros opcionales completed y overdue, que el servicio convierte
en una sola consulta. Una decisión más ahí: si una tarea está atrasada se
calcula en el servidor, en el momento de la petición, y se envía como un
campo. Si cada cliente lo calculara con su propio reloj y su zona
horaria, dos dispositivos podrían no estar de acuerdo sobre la misma
tarea.
Tareas recurrentes que no se acumulan
Este fue el problema de diseño más interesante del backend.
La forma clásica de implementar una tarea recurrente es generar todas sus repeticiones futuras al crearla. Una tarea diaria durante un año son 365 filas. Deja de usar la app a la semana y 358 sobran. Peor: si las repeticiones siguen apareciendo hayas hecho o no la anterior, una semana sin entrar te deja siete tareas pendientes idénticas, una pila que hace que la app parezca un reproche.
RedCheck las genera de una en una. Un proceso programado se ejecuta cada noche a medianoche y, por cada tarea recurrente activa, crea la siguiente solo si se cumplen dos condiciones: la última se ha completado, y hoy es el día que toca según su frecuencia.
La base de datos solo guarda las tareas que de verdad importan, y saltarse un día nunca se convierte en una montaña de pendientes. El compromiso es deliberado: si no completas una tarea recurrente, no vuelve hasta que lo haces. La primera versión admitía cuatro frecuencias fijas: diaria, semanal, cada dos semanas y mensual. Meses después, la renovación del calendario (parte 14) la sustituyó por días de la semana personalizados y rachas.
El progreso, guardado una vez al día
Los colores del calendario salen de la tabla PROGRESS_RECORD de la
parte 1. Un segundo proceso programado se ejecuta a las 23:59 y toma una
foto del día de cada usuario: las tareas completadas ese día, frente a
todo lo que seguía pendiente. El calendario lee una fila por día en lugar
de contar tareas.
Es un intercambio clásico: lecturas baratas a cambio de un número que se congela al escribirse. Si hoy completas una tarea de ayer, el color de ayer no cambia. Para un mapa de calor histórico, donde el pasado cambia poco, era aceptable. Mucho después, para las rachas, tomé la decisión contraria y las calculé al leer, porque un contador guardado se desvía en cuanto alguien desmarca una tarea pasada. El mismo tipo de problema, otra respuesta, según lo a menudo que cambien los datos.
Con qué me quedo de esta etapa
- Trabajando solo, dividir por capas funcionó mejor que dividir por funcionalidades. El coste fueron semanas sin nada que enseñar; el premio, un frontend que nunca esperó al backend.
- La autenticación sin sesiones es sencilla hasta que necesitas revocar algo. Conviene saberlo antes de elegirla.
- A menudo, los mejores datos son los que no creas. Generar las tareas recurrentes bajo demanda mantuvo limpias tanto la base de datos como la lista del usuario.
La siguiente parte es la otra mitad: convertir un boceto en una interfaz, en diez días.
- Backend