SmartCheck moves out
Pulling RedCheck's AI out of the Java backend into its own Python service, and then discovering the RAG had been reading from an empty database.
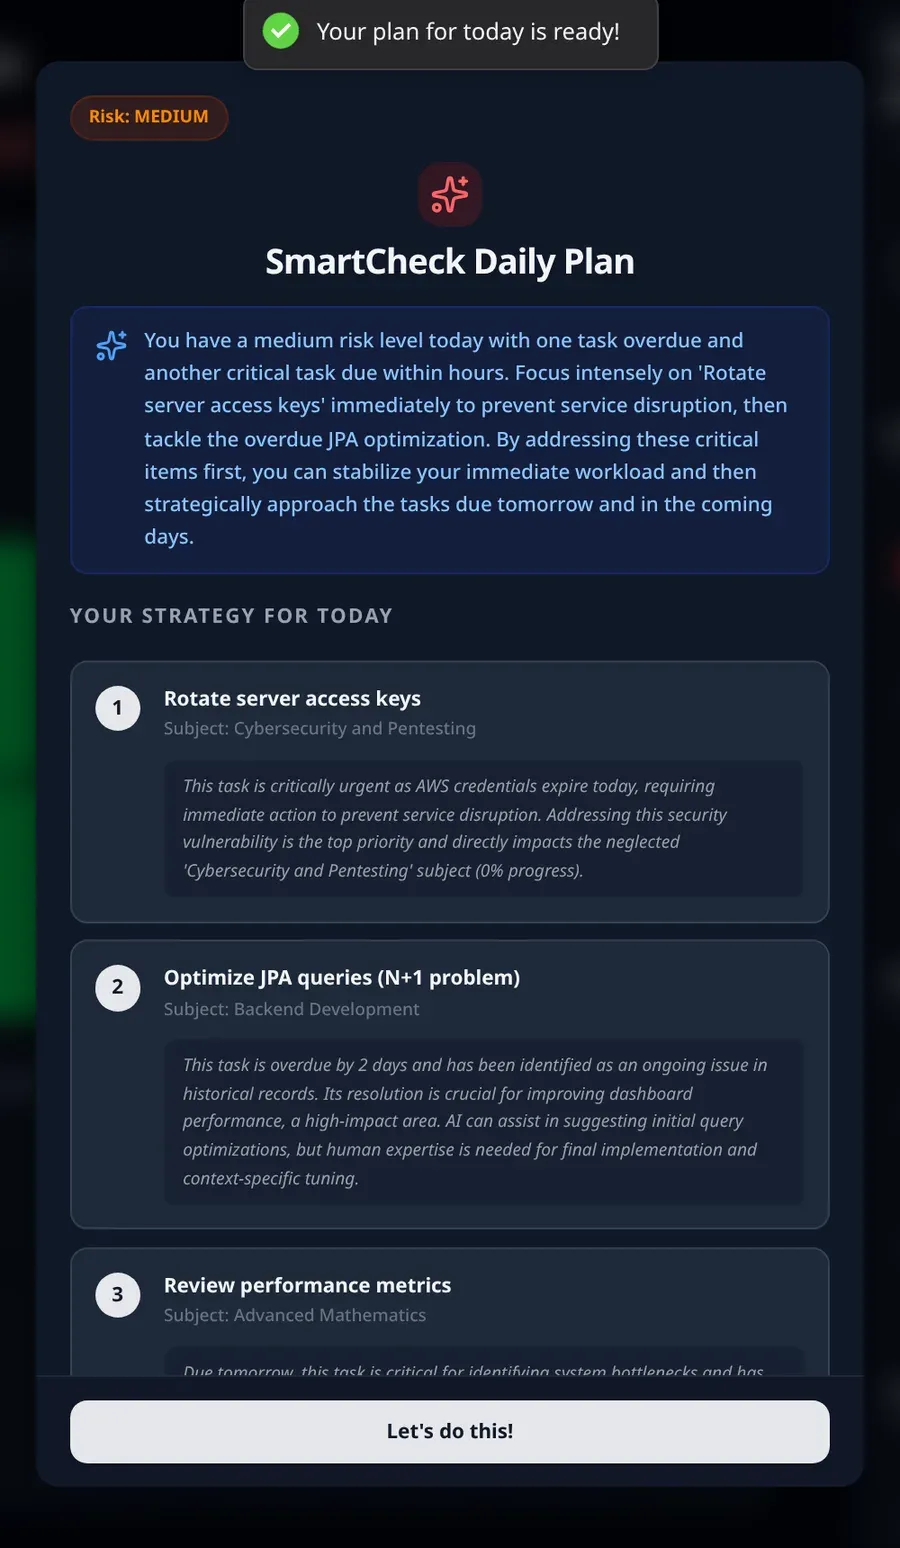
SmartCheck is the reason RedCheck exists. You give it your pending tasks and it gives you back an ordered plan for the day, a risk level, and a short explanation of why each task sits where it does.
Until the end of August, all of that lived inside the Spring Boot backend. This post is about moving it out into its own service, and about what I found when I looked closely at the retrieval part afterwards. Short version: the architecture diagram was right, and the system it described wasn’t quite running.
Where it started
The backend had an AIService interface with two implementations: one
calling Google’s Gemini API, and one calling a local Llama model through
Ollama, selected by configuration. The backend built the prompt, sent
it, parsed the reply and stored the result. The request is asynchronous:
the frontend asks for a plan, the backend starts the analysis in the
background, and the client is notified when it’s ready.
It worked, but every AI concern (prompting, retrieval, validation, embeddings) was being written in Java, next to the code for tasks and subjects. The tools I wanted for the next step, a vector store and the Gemini SDK, are first-class in Python and second-class everywhere else.
The split
smartcheck-ai-engine is a FastAPI service in its own container,
reachable only from inside the Docker network. The Java backend now does
three things:
- Gathers the user’s pending tasks plus some analytics (per-subject completion history) into one payload.
- Sends it to the engine over an internal HTTP call.
- Stores and serves the result.
Both the Gemini and Ollama implementations were deleted from the backend. Choosing a model is now the engine’s problem.
The trade-offs, as I see them:
- Gained: the right ecosystem for the job, an AI component that can be deployed, restarted and iterated on without touching the core API, and a backend that’s back to doing backend things.
- Paid: one more container, one more network hop, and, most importantly, a contract between two languages that nothing enforces. Java sends JSON, Python reads JSON, and if a field name drifts on one side, nothing fails loudly. Keep that in mind for later.
The engine’s pipeline
The engine combines three inputs before it ever calls the model: the current tasks, the user’s history from a vector store (ChromaDB), and the current date and time. Gemini 2.5 Flash then returns a structured JSON plan, ranked across six dimensions: urgency, how much of the task could be delegated to AI tools, the user’s own history, cognitive effort, dependencies between tasks, and balance across subjects.
That was the first version. Then I sat down to review it properly.
The RAG had nothing to retrieve
Retrieval-augmented generation needs two paths: a read path that fetches relevant history at query time, and a write path that stores that history in the first place. The read path was implemented. The write path did not exist. Nothing ever wrote to the vector store. Every plan had been generated with an empty “history” section, and because the model still produced a sensible-looking plan, nothing seemed wrong.
That’s the uncomfortable thing about LLM systems: missing context doesn’t crash anything. It just quietly makes the output a bit more generic.
So the redesign started there:
- A task-outcome endpoint on the engine. When a user completes or reopens a task, the backend now reports the outcome to it asynchronously: when it was due, when it was actually done, and so on. A failure there is logged and never rolls back the user’s action. The task is the source of truth; the AI’s memory is best-effort.
- Two collections instead of one.
task_outcomesholds individual records, searched semantically.user_patternsholds one aggregated document per user and subject (completion rate, average delay, how often the user followed the suggested order), recomputed after every new outcome and looked up by exact match rather than similarity. Both are combined into a single labelled context block for the prompt.
Don’t make the model do arithmetic
Reading the prompt again, I noticed I was asking Gemini to work out how many days were left until each deadline, which tasks fell on the same day, and which tasks blocked others. Language models are not reliable at date arithmetic, and there’s no reason to ask them to be.
All of that is now computed in Python before the prompt is built: days until due, an urgency bucket, same-day task density, and dependency resolution. The prompt tells the model to trust those fields instead of re-deriving them. The model’s job is reduced to the part it’s actually good at: weighing those signals and explaining the result in plain language.
Retrieval that actually ranks
Taking ChromaDB’s raw top three results by similarity wasn’t good enough. A very similar task from eight months ago is less predictive than a slightly less similar one from last week. Retrieval now pulls a wider pool of candidates and re-ranks them on three things: semantic similarity, recency (with a smooth decay), and whether the subject matches one of today’s tasks.
While doing this I found that the collections had never been configured for cosine distance. Chroma defaults to squared L2, and every diagram I’d drawn said “cosine”. Another silent one.
Validate, retry, fail cleanly
The model is asked for a strict JSON schema, but “asked for” isn’t
“guaranteed”. Every response is now validated against the schema, not
just parsed as JSON, and the engine retries up to three times. If all
attempts fail, it returns a clean 502 instead of an unhandled
exception. The backend also refuses to start an analysis when there are
no pending tasks: asking the model to prioritise an empty list used to
leave the request hanging with nothing ever coming back.
Bugs found along the way
Reviewing the two sides of the contract together turned up the kind of bugs you only find by reading both:
- Field names assumed on the Python side didn’t fully match what Java actually sent, so part of the retrieval query was being built from missing data. The fix was to check the real Java code instead of trusting a DTO that looked right.
- An early test had created a collection with a 4-dimensional embedding, on the real persistent store. Gemini’s embeddings have 3,072 dimensions. It would have broken retrieval in production, silently, the moment real data arrived. The collections were dropped and recreated.
Everything was then verified end to end against the real Gemini API, no mocks: outcomes ingested, patterns aggregated, and a generated plan whose reasoning correctly referred to that history.
How it fits together now
The last step is the one that was missing: every outcome feeds the store that the next plan reads from.
What I deliberately didn’t build
- An agent loop. Letting the model request more history through function calling is the obvious next step. It’s also a much bigger change (multi-turn tool use, deciding which tools to expose), and single-shot retrieval already covers the common case. Deferred, not rejected.
- Plan-level feedback. I’d like to measure whether a whole day’s plan was accurate, not just individual tasks. That needs a way to link task outcomes back to the plan they came from, and nothing tracks that yet.
What I took away
- In a RAG system, check the write path first. An empty store looks exactly like a working one.
- Anything deterministic belongs in code, not in the prompt.
- Splitting services across languages is worth it, but the contract between them is now your problem. Read both sides.
- Validate structured output against its schema, and decide in advance what happens when it never validates.
The engine is open source: smartcheck-ai-engine. You can try SmartCheck with the demo account at redcheckapp.com.
SmartCheck es la razón por la que existe RedCheck. Le das tus tareas pendientes y te devuelve un plan ordenado para el día, un nivel de riesgo y una breve explicación de por qué cada tarea está donde está.
Hasta finales de agosto, todo eso vivía dentro del backend de Spring Boot. Este post trata de sacarlo a su propio servicio, y de lo que encontré cuando miré con lupa la parte de recuperación. En resumen: el diagrama de arquitectura estaba bien, y el sistema que describía no estaba funcionando del todo.
De dónde partía
El backend tenía una interfaz AIService con dos implementaciones: una
que llamaba a la API de Gemini de Google y otra que llamaba a un modelo
Llama local a través de Ollama, elegida por configuración. El backend
construía el prompt, lo enviaba, interpretaba la respuesta y guardaba el
resultado. La petición es asíncrona: el frontend pide un plan, el backend
lanza el análisis en segundo plano y se avisa al cliente cuando está
listo.
Funcionaba, pero toda la lógica de IA (prompts, recuperación, validación, embeddings) se estaba escribiendo en Java, junto al código de tareas y asignaturas. Las herramientas que quería para el siguiente paso, una base de datos vectorial y el SDK de Gemini, son de primera clase en Python y de segunda en todo lo demás.
La separación
smartcheck-ai-engine es un servicio FastAPI en su propio contenedor,
accesible solo desde dentro de la red de Docker. El backend en Java ahora
hace tres cosas:
- Reúne las tareas pendientes del usuario y algunas analíticas (historial de cumplimiento por asignatura) en un único payload.
- Lo envía al motor mediante una llamada HTTP interna.
- Guarda y sirve el resultado.
Las implementaciones de Gemini y Ollama se borraron del backend. Elegir modelo ahora es problema del motor.
Los compromisos, tal y como yo los veo:
- Lo que gané: el ecosistema adecuado para el trabajo, un componente de IA que se puede desplegar, reiniciar y evolucionar sin tocar la API principal, y un backend que vuelve a hacer cosas de backend.
- Lo que pagué: un contenedor más, un salto de red más y, sobre todo, un contrato entre dos lenguajes que nada hace cumplir. Java envía JSON, Python lee JSON, y si el nombre de un campo cambia en un lado, nada falla de forma visible. Tenlo en mente para más adelante.
El pipeline del motor
El motor combina tres entradas antes de llamar al modelo: las tareas actuales, el historial del usuario guardado en una base de datos vectorial (ChromaDB) y la fecha y hora actuales. Después, Gemini 2.5 Flash devuelve un plan en JSON estructurado, ordenado según seis dimensiones: urgencia, cuánto de la tarea se podría delegar en herramientas de IA, el historial del propio usuario, el esfuerzo cognitivo, las dependencias entre tareas y el equilibrio entre asignaturas.
Esa fue la primera versión. Luego me senté a revisarla en serio.
El RAG no tenía nada que recuperar
La generación aumentada por recuperación (RAG) necesita dos caminos: uno de lectura, que busca el historial relevante en el momento de la consulta, y uno de escritura, que guarda ese historial en primer lugar. El de lectura estaba implementado. El de escritura no existía. Nada escribía nunca en la base de datos vectorial. Todos los planes se habían generado con la sección de “historial” vacía y, como el modelo seguía produciendo un plan razonable, nada parecía ir mal.
Eso es lo incómodo de los sistemas con LLM: que falte contexto no rompe nada. Simplemente hace que la respuesta sea, sin que se note, un poco más genérica.
Así que el rediseño empezó por ahí:
- Un endpoint de resultados de tareas en el motor. Cuando un usuario completa o reabre una tarea, el backend le informa del resultado de forma asíncrona: cuándo vencía, cuándo se hizo realmente, etc. Si eso falla, se registra en el log y nunca deshace la acción del usuario. La tarea es la fuente de verdad; la memoria de la IA es un “lo que se pueda”.
- Dos colecciones en lugar de una.
task_outcomesguarda registros individuales y se busca por similitud semántica.user_patternsguarda un documento agregado por usuario y asignatura (tasa de cumplimiento, retraso medio, cuántas veces siguió el orden sugerido), que se recalcula con cada resultado nuevo y se consulta por coincidencia exacta, no por similitud. Las dos se combinan en un único bloque de contexto etiquetado para el prompt.
No pongas al modelo a hacer cuentas
Al releer el prompt me di cuenta de que le estaba pidiendo a Gemini que calculara cuántos días faltaban para cada fecha límite, qué tareas caían el mismo día y cuáles bloqueaban a otras. Los modelos de lenguaje no son fiables con la aritmética de fechas, y no hay ninguna razón para pedírselo.
Ahora todo eso se calcula en Python antes de construir el prompt: días hasta el vencimiento, un nivel de urgencia, la densidad de tareas en el mismo día y la resolución de dependencias. El prompt le indica al modelo que se fíe de esos campos en lugar de volver a deducirlos. Su trabajo queda reducido a lo que de verdad hace bien: sopesar esas señales y explicar el resultado en lenguaje natural.
Una recuperación que ordena de verdad
Quedarse con los tres primeros resultados por similitud que devuelve ChromaDB no era suficiente. Una tarea muy parecida de hace ocho meses predice peor que una algo menos parecida de la semana pasada. Ahora la recuperación trae un conjunto más amplio de candidatos y los reordena según tres criterios: similitud semántica, antigüedad (con un decaimiento suave) y si la asignatura coincide con alguna de las tareas de hoy.
Haciendo esto descubrí que las colecciones nunca se habían configurado para usar distancia coseno. Chroma usa por defecto la distancia L2 al cuadrado, y todos los diagramas que había dibujado decían “coseno”. Otro fallo silencioso.
Validar, reintentar y fallar limpiamente
Al modelo se le pide un esquema JSON estricto, pero “pedido” no es
“garantizado”. Ahora cada respuesta se valida contra el esquema, no solo
se interpreta como JSON, y el motor reintenta hasta tres veces. Si todos
los intentos fallan, devuelve un 502 limpio en lugar de una excepción
sin controlar. El backend, además, se niega a lanzar un análisis cuando
no hay tareas pendientes: pedirle al modelo que priorizara una lista
vacía dejaba la petición colgada sin que llegara nunca nada.
Bugs encontrados por el camino
Revisar los dos lados del contrato a la vez sacó a la luz el tipo de bug que solo encuentras leyendo ambos:
- Los nombres de campo que asumía el lado de Python no coincidían del todo con lo que Java enviaba de verdad, así que parte de la consulta de recuperación se construía con datos que faltaban. La solución fue comprobar el código real de Java en lugar de fiarme de un DTO que parecía correcto.
- Un test antiguo había creado una colección con embeddings de 4 dimensiones, sobre la base de datos persistente real. Los embeddings de Gemini tienen 3.072. Habría roto la recuperación en producción, en silencio, en cuanto llegaran datos reales. Las colecciones se borraron y se volvieron a crear.
Después se verificó todo de punta a punta contra la API real de Gemini, sin mocks: resultados ingeridos, patrones agregados y un plan generado cuyo razonamiento hacía referencia correctamente a ese historial.
Cómo encaja todo ahora
El último paso es el que faltaba: cada resultado alimenta la base de datos que lee el siguiente plan.
Lo que decidí no construir
- Un bucle de agente. Dejar que el modelo pida más historial mediante function calling es el siguiente paso obvio. También es un cambio mucho mayor (uso de herramientas en varios turnos, decidir qué herramientas exponer), y la recuperación en un único paso ya cubre el caso habitual. Aplazado, no descartado.
- Feedback a nivel de plan. Me gustaría medir si el plan de un día entero acertó, no solo tareas sueltas. Para eso hace falta enlazar los resultados de las tareas con el plan del que salieron, y ahora mismo nada lo registra.
Con qué me quedo
- En un sistema RAG, revisa primero el camino de escritura. Una base de datos vacía parece exactamente igual que una que funciona.
- Todo lo determinista va en el código, no en el prompt.
- Separar servicios en distintos lenguajes merece la pena, pero el contrato entre ellos pasa a ser tu problema. Lee los dos lados.
- Valida la salida estructurada contra su esquema, y decide de antemano qué pasa cuando nunca valida.
El motor es de código abierto: smartcheck-ai-engine. Puedes probar SmartCheck con la cuenta demo en redcheckapp.com.
- AI
- Backend