A front door for RedCheck
Splitting RedCheck into a static landing page and an app subdomain, moving infrastructure into its own repo, and making the site readable by AI agents.
For its first months, RedCheck’s front door was a login form. If you followed a link to it, the first thing you were asked to do was hand over an email address, with no idea what you were signing up for.
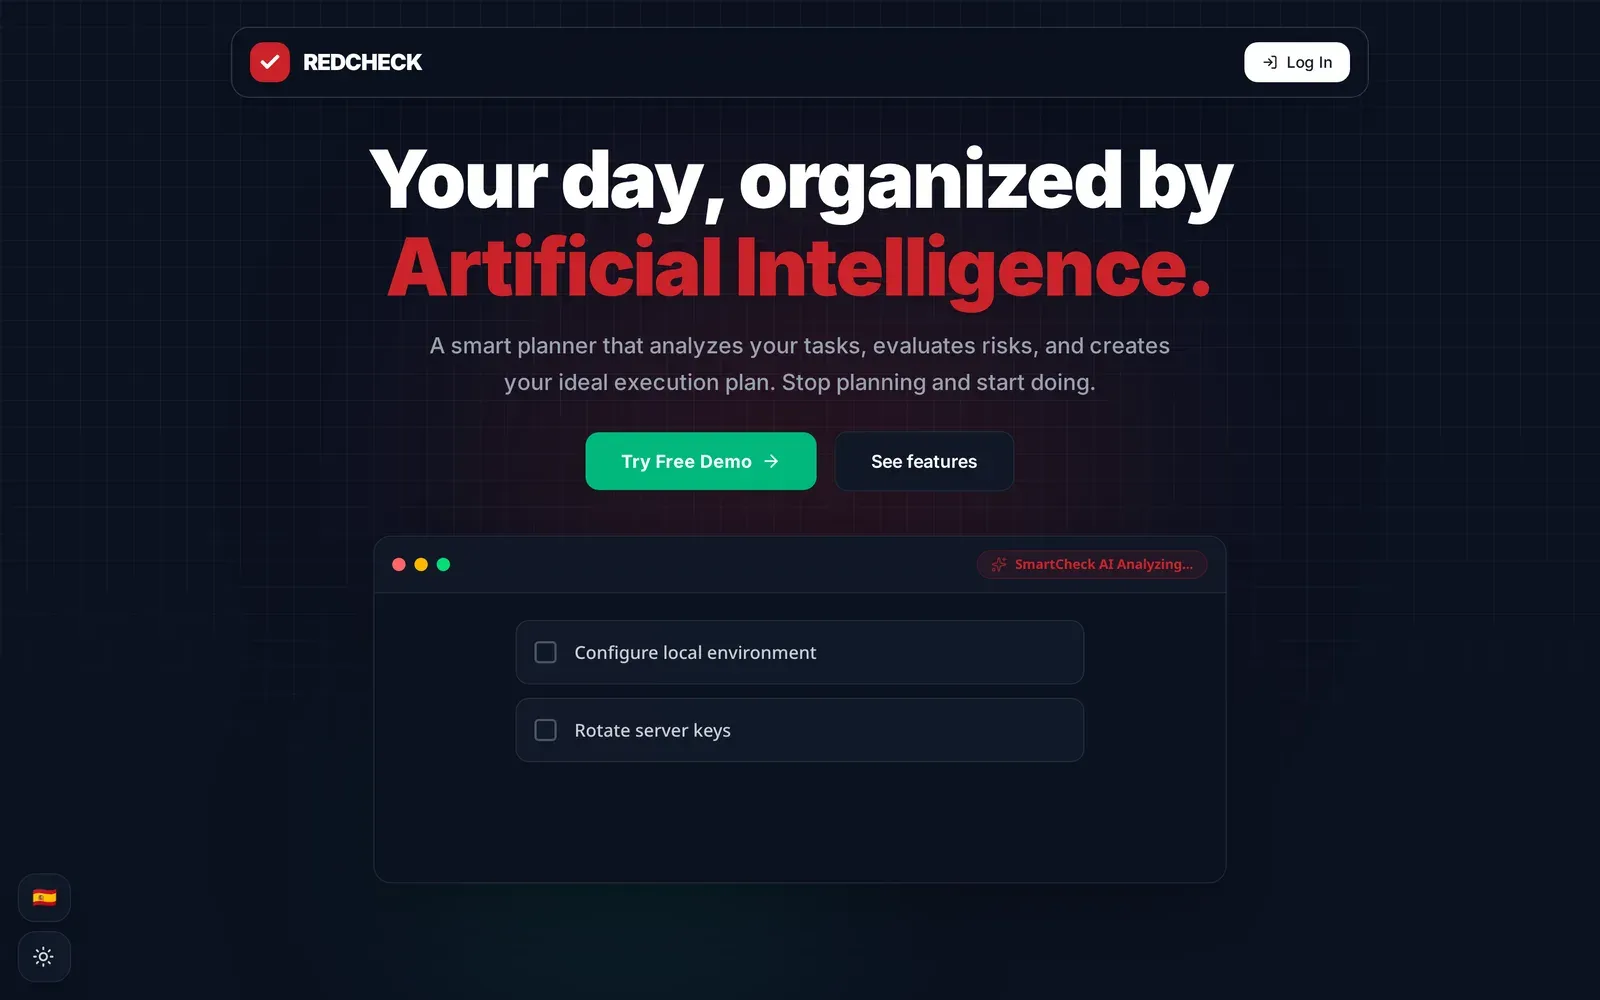
That’s backwards. So at the end of August I built a proper landing page, and in the process RedCheck went from “one app on a domain” to a small system with a clear shape:
redcheckapp.com: a static landing page, built with Astro.my.redcheckapp.com: the React app itself.redcheck-infrastructure: a new repository that owns thedocker-compose.yml, the nginx configuration and the database seed scripts.
Why a separate site and not another route in the app
I could have added a / route to the existing React app and called it
the landing page. I chose not to, for three reasons:
- Speed and SEO. A single-page app ships a JavaScript bundle before it can show anything meaningful. A marketing page should be plain HTML that a crawler, a slow phone or a link preview can read instantly. Astro gives me that by default and only hydrates the few interactive pieces.
- Different release cadence. Copy changes, screenshots and GIFs on the landing page have nothing to do with the app’s code. Separating them means fixing a typo doesn’t rebuild and redeploy the product.
- Clear boundaries. The landing page is public and crawlable. The app is authenticated. Putting them on different hosts makes that boundary explicit, for people and for bots.
The cost is that two sites now have to feel like one. Theme and
language are the obvious examples: a visitor who chooses English and dark
mode on the landing page should arrive at the login screen in English and
dark mode. That’s why those preferences live in a cookie scoped to the
parent domain instead of localStorage, which is per-origin.
What’s on the page
The page tells a short story: the problem (too many tasks, no idea where to start), how RedCheck approaches it, a quick interactive demo of the AI sorting a list by risk, and a short personal section about why I’m building it.
The feature section uses GIFs and screenshots of the real app. Since the app has two themes and two languages, every asset exists in four versions (light and dark, English and Spanish), and the page shows the one that matches the visitor’s current settings. That’s more assets to maintain, but showing a Spanish light-mode screenshot to an English user in dark mode looks careless.
Performance and mobile
The first version was heavy: about 4.1 MB of images. Converting them to
WebP with a PNG/GIF fallback through <picture>, adding explicit
dimensions to avoid layout shift, and lazy-loading everything below the
fold took that down to roughly 724 KB.
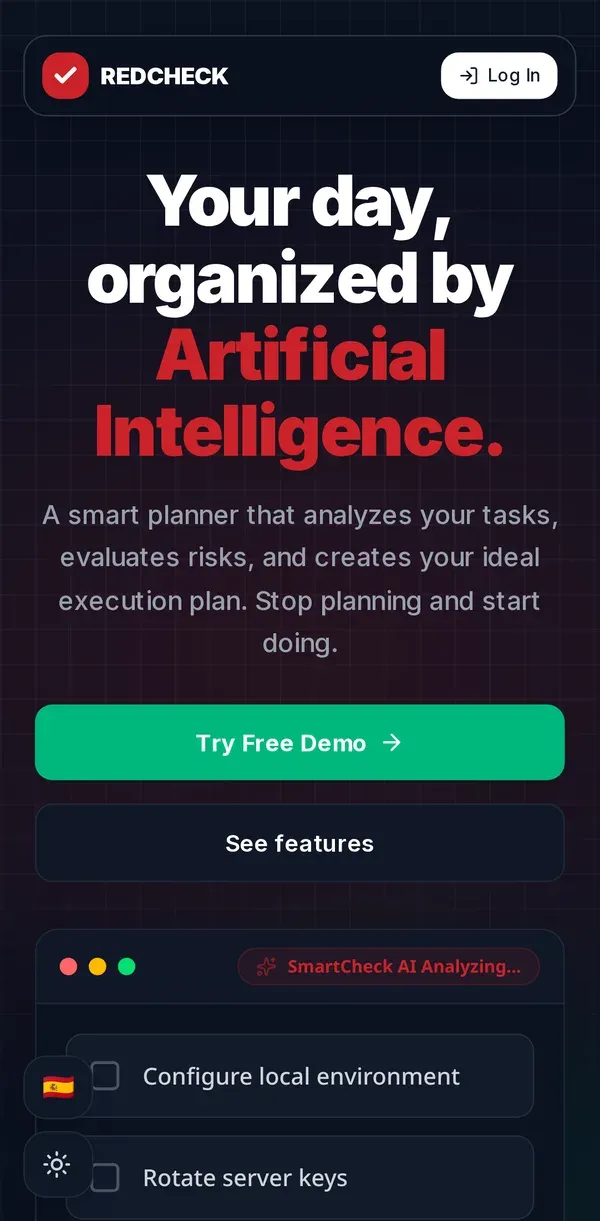
Mobile needed its own pass. A few things I ran into:
- The fixed navbar covered the hero heading on small screens.
overflow-x: hiddenon<body>alone wasn’t enough on some mobile browsers; the page could still drift sideways and drag the fixed navbar with it. It had to go on<html>too.- A three-column “how it works” grid doesn’t work at 360 px, so on phones it became a tap-to-advance carousel, one step at a time. Desktop keeps the grid.
- The animated particle background was reduced on mobile: fewer particles and links, for smoother scrolling and less battery drain.
Add canonical URLs, Open Graph and Twitter Card metadata, a generated social preview image, and JSON-LD describing the application, the organisation and the person behind it, and the page is in good shape for search engines and link previews.
Making the site readable by AI agents
This is the part I found most interesting. More and more people ask an assistant about a product instead of searching for it, and those assistants increasingly read websites directly. So I treated AI agents as a second audience:
llms.txt, following the llmstxt.org format: a plain-text summary of what RedCheck is, how it’s built, and where to find things, written to be dropped straight into a model’s context.robots.txtexplicitly lists the current AI crawlers (OpenAI, Anthropic, Google, Perplexity, Apple and others), and uses a content signal that allows the page to be used as input for answering questions, while disallowing its use for model training. I’m happy for an assistant to read RedCheck’s page to answer a user’s question. I don’t need it baked into the next foundation model.- Machine-readable discovery documents under
/.well-known/: an API catalogue (RFC 9727) and OAuth authorization-server and protected-resource metadata (RFC 8414 and RFC 9728), plus anauth.mddescribing how authentication works. nginx advertises the catalogue with aLinkheader on every response.
One small infrastructure detail made this harder than expected: those
.well-known files have no extension, so nginx served them with a
generic content type. Agents and validators expect
application/linkset+json or application/json, so nginx now overrides
the content type for those exact paths.
Is this premature for a project of this size? Possibly. But it’s cheap, it’s static, and it’s the kind of thing that is much easier to design in from the start than to retrofit.
Infrastructure gets its own repository
With a landing page, a frontend, a backend, a database and (as the previous
post explains) a separate AI service, the docker-compose.yml and the
nginx config no longer belonged inside any one application’s repository.
They describe how the pieces fit together, so they now live in
redcheck-infrastructure.
Each application still builds and deploys its own Docker image through its own pipeline. The infrastructure repository is the one place that says which images run, how they talk to each other, and how traffic reaches them. That split has a sharp edge, which I found out the hard way a couple of weeks later. I’ll cover it in the next post.
What I took away
- A product needs a front door that explains it before asking for anything.
- Static sites are still the right tool for pages whose job is to be read.
- Splitting into subdomains is easy. Making them feel like one site is the actual work.
- AI agents are a real audience now. A few static files go a long way, and you get to choose what they can and can’t do with your content.
Have a look at redcheckapp.com, on your phone if you can.
Durante sus primeros meses, la puerta de entrada de RedCheck era un formulario de login. Si llegabas por un enlace, lo primero que se te pedía era un correo electrónico, sin tener ni idea de a qué te estabas apuntando.
Eso es empezar la casa por el tejado. Así que a finales de agosto construí una landing en condiciones, y por el camino RedCheck pasó de ser “una app en un dominio” a un pequeño sistema con una forma clara:
redcheckapp.com: una landing estática, hecha con Astro.my.redcheckapp.com: la app de React.redcheck-infrastructure: un repositorio nuevo que se encarga deldocker-compose.yml, la configuración de nginx y los scripts de datos iniciales de la base de datos.
Por qué un sitio aparte y no otra ruta en la app
Podría haber añadido una ruta / a la app de React y llamarla landing.
Decidí no hacerlo por tres motivos:
- Velocidad y SEO. Una single-page app tiene que enviar un bundle de JavaScript antes de poder enseñar nada útil. Una página de marketing debería ser HTML plano que un crawler, un móvil lento o la vista previa de un enlace puedan leer al instante. Astro me da eso por defecto y solo hidrata las pocas piezas interactivas.
- Ritmos de publicación distintos. Los textos, capturas y GIFs de la landing no tienen nada que ver con el código de la app. Separarlos significa que corregir una errata no recompila ni redespliega el producto.
- Fronteras claras. La landing es pública y rastreable. La app requiere autenticación. Ponerlas en hosts distintos hace explícita esa frontera, para las personas y para los bots.
El coste es que ahora dos sitios tienen que sentirse como uno. El tema
y el idioma son el ejemplo obvio: quien elige inglés y modo oscuro en la
landing debería llegar a la pantalla de login en inglés y en modo oscuro.
Por eso esas preferencias viven en una cookie asociada al dominio padre en
vez de en localStorage, que va por origen.
Qué hay en la página
La página cuenta una historia corta: el problema (demasiadas tareas y ninguna idea de por dónde empezar), cómo lo aborda RedCheck, una demo interactiva rápida de la IA ordenando una lista por riesgo y una pequeña sección personal sobre por qué lo estoy construyendo.
La sección de funcionalidades usa GIFs y capturas de la app real. Como la app tiene dos temas y dos idiomas, cada recurso existe en cuatro versiones (claro y oscuro, inglés y español), y la página muestra la que corresponde a la configuración del visitante. Son más recursos que mantener, pero enseñarle una captura en español y en modo claro a alguien que navega en inglés y en modo oscuro da sensación de descuido.
Rendimiento y móvil
La primera versión pesaba mucho: unos 4,1 MB de imágenes. Convertirlas a
WebP con PNG o GIF de respaldo mediante <picture>, añadir dimensiones
explícitas para evitar saltos de maquetación y cargar en diferido todo lo
que queda por debajo del primer pantallazo lo dejó en unos 724 KB.
El móvil necesitó su propia pasada. Algunas cosas con las que me encontré:
- La barra de navegación fija tapaba el titular principal en pantallas pequeñas.
overflow-x: hiddensolo en<body>no bastaba en algunos navegadores móviles; la página aún podía desplazarse de lado y arrastrar consigo la barra fija. Hubo que ponerlo también en<html>.- Una cuadrícula de tres columnas para “cómo funciona” no cabe en 360 px, así que en móvil se convirtió en un carrusel que avanza con cada toque, un paso cada vez. En escritorio se mantiene la cuadrícula.
- El fondo animado de partículas se redujo en móvil: menos partículas y menos conexiones, para un scroll más fluido y menos gasto de batería.
Si a eso le sumas URLs canónicas, metadatos de Open Graph y Twitter Card, una imagen de vista previa generada y JSON-LD que describe la aplicación, la organización y la persona que hay detrás, la página queda en buena forma para buscadores y vistas previas de enlaces.
Que la web la puedan leer agentes de IA
Esta es la parte que más me interesó. Cada vez más gente le pregunta a un asistente por un producto en lugar de buscarlo, y esos asistentes leen las webs directamente cada vez más. Así que traté a los agentes de IA como un segundo público:
llms.txt, siguiendo el formato de llmstxt.org: un resumen en texto plano de qué es RedCheck, cómo está construido y dónde encontrar cada cosa, escrito para meterlo tal cual en el contexto de un modelo.robots.txtenumera explícitamente los crawlers de IA actuales (OpenAI, Anthropic, Google, Perplexity, Apple y otros) y usa una señal de contenido que permite usar la página como entrada para responder preguntas, pero prohíbe usarla para entrenar modelos. Me parece bien que un asistente lea la página de RedCheck para responder a la pregunta de un usuario. No necesito que acabe dentro del próximo modelo fundacional.- Documentos de descubrimiento legibles por máquinas en
/.well-known/: un catálogo de API (RFC 9727) y los metadatos OAuth del servidor de autorización y del recurso protegido (RFC 8414 y RFC 9728), además de unauth.mdque explica cómo funciona la autenticación. nginx anuncia el catálogo con una cabeceraLinken cada respuesta.
Un pequeño detalle de infraestructura lo complicó más de lo esperado:
esos ficheros de .well-known no tienen extensión, así que nginx los
servía con un tipo de contenido genérico. Los agentes y validadores
esperan application/linkset+json o application/json, así que ahora
nginx sobrescribe el tipo de contenido para esas rutas exactas.
¿Es prematuro para un proyecto de este tamaño? Puede. Pero es barato, es estático, y es de esas cosas que cuesta mucho menos diseñar desde el principio que añadir después.
La infraestructura tiene su propio repositorio
Con una landing, un frontend, un backend, una base de datos y (como
explica el post anterior) un servicio de IA aparte, el
docker-compose.yml y la configuración de nginx ya no pertenecían a
ningún repositorio de aplicación concreto. Describen cómo encajan las
piezas, así que ahora viven en redcheck-infrastructure.
Cada aplicación sigue construyendo y desplegando su propia imagen de Docker con su propio pipeline. El repositorio de infraestructura es el único sitio que dice qué imágenes se ejecutan, cómo se comunican entre ellas y cómo les llega el tráfico. Esa separación tiene una arista afilada que descubrí por las malas un par de semanas después. Lo cuento en el siguiente post.
Con qué me quedo
- Un producto necesita una puerta de entrada que lo explique antes de pedir nada.
- Los sitios estáticos siguen siendo la herramienta adecuada para páginas cuyo trabajo es ser leídas.
- Separar en subdominios es fácil. Conseguir que se sientan como un solo sitio es el trabajo de verdad.
- Los agentes de IA ya son un público real. Unos pocos ficheros estáticos llegan lejos, y decides tú qué pueden y qué no pueden hacer con tu contenido.
Echa un vistazo a redcheckapp.com, desde el móvil si puedes.
- Frontend
- DevOps